并发编程进阶:协程与异步
并发编程是一种编程模式,旨在使程序能够同时执行多个任务或操作。
它涉及到同时处理多个独立任务的能力,这些任务可以在同一时间段内或者在不同的时间段内并行执行。
在传统的单线程编程模型中,程序按照顺序依次执行指令,每个操作都必须在上一个操作完成后才能开始。
这种模型的缺点是,在处理耗时的操作时,程序可能会出现停顿或阻塞,导致执行效率低下。
并发编程通过引入多个执行线程或进程,使得程序能够并行执行多个任务,从而提高系统的吞吐量和响应性能。
每个线程或进程可以独立地执行任务,它们之间可以交替执行,或者同时执行不同的任务。
这种并行执行的方式可以充分利用多核处理器的优势,同时还可以提升对输入/输出等耗时操作的处理效率。
总之,并发编程是一种利用多线程或多进程实现并行执行的编程模式,它可以提高程序的性能和响应性,并充分利用多核处理器的潜力。
然而,并发编程也带来了一些挑战,如资源竞争和数据同步,需要合理地设计和管理以确保程序的正确性和可靠性。
进程、线程与协程
1)进程概念
我们都知道计算机的核心是CPU,它承担了所有的计算任务;而操作系统是计算机的管理者,它负责任务的调度、资源的分配和管理,统领整个计算机硬件;应用程序则是具有某种功能的程序,程序是运行于操作系统之上的。
进程是一个具有一定独立功能的程序在一个数据集上的一次动态执行的过程,是操作系统进行资源分配和调度的一个独立单位,是应用程序运行的载体。
- 多道技术:空间复用+时间复用,于是有了多进程!
进程是一种抽象的概念,从来没有统一的标准定义。进程一般由程序、数据集合和进程控制块三部分组成。
例子:我和我的女朋友们的故事
我就是CPU,我跟三个女朋友玩就是三个任务
1. 我教第一个女朋友 做菜   ,菜谱就是程序    ,食材就是数据  ,我做饭的过程就是一个进程(切换,状态保存)
2. 我给第二个女朋友 治疗脚伤,医疗手册就是程序,医药箱就是数据,治疗脚伤的过程就是第二个进程
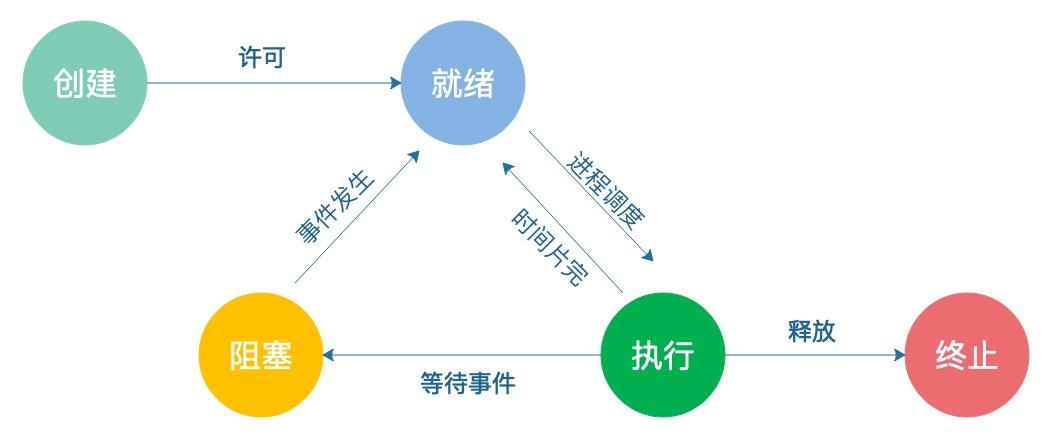
。。。进程状态反映进程执行过程的变化。这些状态随着进程的执行和外界条件的变化而转换。
- 在三态模型中,进程状态分为三个基本状态,即运行态,就绪态,阻塞态。
- 在五态模型中,进程分为新建态、终止态,运行态,就绪态,阻塞态。
2)线程的概念
在早期的操作系统中并没有线程的概念,进程是能拥有资源和独立运行的最小单位,也是程序执行的最小单位。
任务调度采用的是时间片轮转的抢占式调度方式,而进程是任务调度的最小单位,每个进程有各自独立的一块内存,使得各个进程之间内存地址相互隔离。
后来,随着计算机的发展,对CPU的要求越来越高,进程之间的切换开销较大,已经无法满足越来越复杂的程序的要求了。于是就发明了线程。
线程是程序执行中一个单一的顺序控制流程,是程序执行流的最小单元,是处理器调度和分派的基本单位。
一个进程可以有一个或多个线程,各个线程之间共享程序的内存空间 (也就是所在进程的内存空间)。
一个标准的线程由线程ID、当前指令指针(PC)、寄存器和堆栈组成。
而进程由内存空间(代码、数据、进程空间、打开的文件)和一个或多个线程组成。
(1)线程的生命周期
在单个处理器运行多个线程时,并发是一种模拟出来的状态。操作系统采用时间片轮转的方式轮流执行每一个线程。
现在,几乎所有的现代操作系统采用的都是时间片轮转的抢占式调度方式,如我们熟悉的Unix、Linux、Windows及macOS等流行的操作系统。
我们知道线程是程序执行的最小单位,也是任务执行的最小单位。
在早期只有进程的操作系统中,进程有五种状态,创建、就绪、运行、阻塞(等待)、退出。
早期的进程相当于现在的只有单个线程的进程,那么现在的多线程也有五种状态,现在的多线程的生命周期与早期进程的生命周期类似。
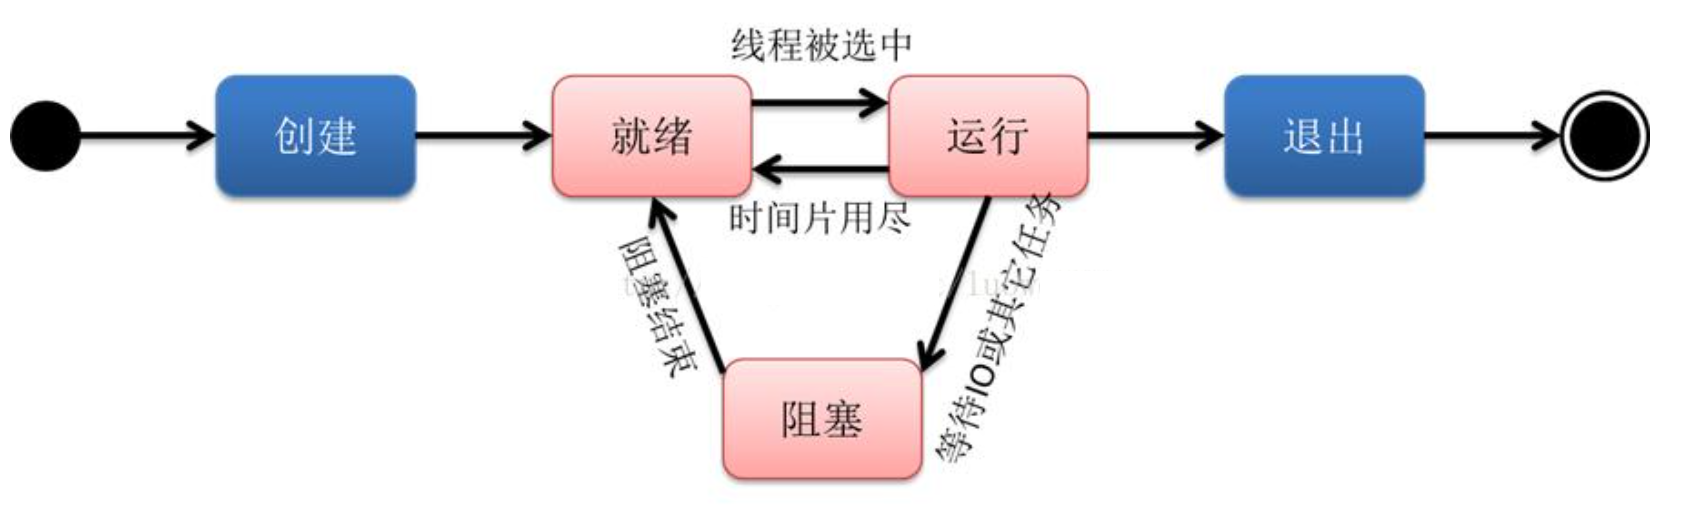
线程的生命周期

# 创建:一个新的线程被创建,等待该线程被调用执行;
# 就绪:时间片已用完,此线程被强制暂停,等待下一个属于它的时间片到来;
# 运行:此线程正在执行,正在占用时间片;
# 阻塞:也叫等待状态,等待某一事件(如IO或另一个线程)执行完;
# 退出:一个线程完成任务或者其他终止条件发生,该线程终止进入退出状态,退出状态释放该线程所分配的资源。
(2)进程与线程的区别
前面讲了进程与线程,但可能你还觉得迷糊,感觉他们很类似。的确,进程与线程有着千丝万缕的关系,下面就让我们一起来理一理:
- 线程是程序执行的最小单位,而进程是操作系统分配资源的最小单位;
- 一个进程由一个或多个线程组成,线程是一个进程中代码的不同执行路线;
- 进程之间相互独立,但同一进程下的各个线程之间共享程序的内存空间(包括代码段、数据集、堆等)及一些进程级的资源(如打开文件和信号),某进程内的线程在其它进程不可见;
- 调度和切换:线程上下文切换比进程上下文切换要快得多。
3)协程 (Coroutines)
协程,英文 Coroutines,是一种基于线程之上,但又比线程更加轻量级的存在,这种由程序员自己写程序来管理的轻量级线程叫做『用户空间线程』,具有对内核来说不可见的特性。因为是自主开辟的异步任务,所以很多人也更喜欢叫它们纤程(Fiber),或者绿色线程(GreenThread)。正如一个进程可以拥有多个线程一样,一个线程也可以拥有多个协程。
协程解决的是线程的切换开销和内存开销的问题
将多个用户级线程映射到一个内核级线程,线程管理在用户空间完成。此模式中,用户级线程对操作系统不可见(即透明)。
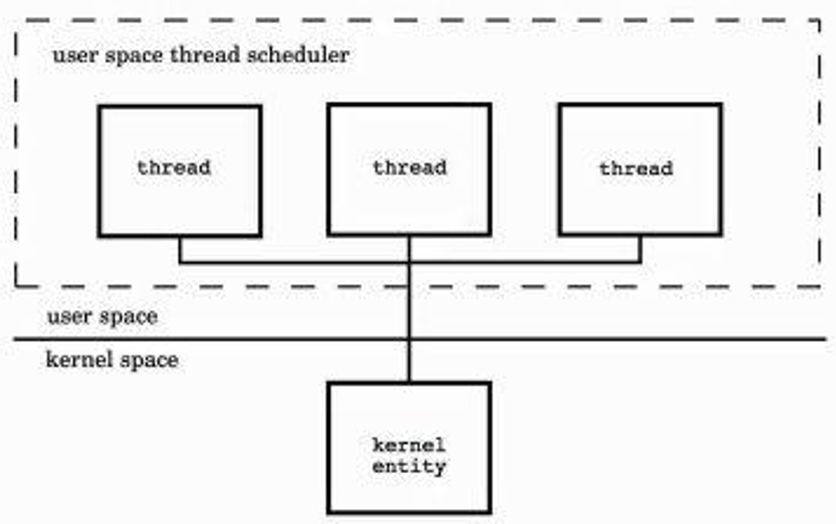
优点: 这种模型的好处是线程上下文切换都发生在用户空间,避免的模态切换(mode switch),从而对于性能有积极的影响。
多线程实现
1)threading模块
Python提供两个模块进行多线程的操作,分别是thread和threading,前者是比较低级的模块,用于更底层的操作,一般应用级别的开发不常用。
串行
pythonimport time def spider01(): print("spider01 start") time.sleep(3) print("spider01 end") def spider02(): print("spider02 start") time.sleep(5) print("spider02 end") spider01() spider02()多线程并发
pythonimport threading import time def spider01(timer): print("spider01 start") time.sleep(timer) # 模拟IO print("spider01 end") def spider02(timer): print("spider02 start") time.sleep(timer) # 模拟IO print("spider02 end") start = time.time() # 创建线程对象 t1 = threading.Thread(target=spider01, args=(3,)) t2 = threading.Thread(target=spider02, args=(5,)) # 线程就绪启动 t1.start() t2.start() # 阻塞等待线程结束 t1.join() t2.join() end = time.time() print("时间花销:", end - start)
2)线程应用案例
多线程并发的CS架构python# 服务端 import socket import threading from loguru import logger def conn_hendler(conn): while 1: # (3) 收消息 data_bytes = conn.recv(1024) # 阻塞函数 print("data:", data_bytes.decode()) if data_bytes == "quit".encode() or len(data_bytes) == 0: logger.info(f"来自于{addr}客户端退出!") break # (4) 处理数据并发送 data = data_bytes.decode() res = data.upper() conn.send(res.encode()) # (1) 构建服务端套接字对象 sock = socket.socket(family=socket.AF_INET, type=socket.SOCK_STREAM) # (2) 服务端三件套:bind listen accept sock.bind(("127.0.0.1", 8899)) # 1. 绑定地址和端口 sock.listen(5) # 2. 建立最大连接数(监听数) logger.info("服务器启动") while 1: logger.info("等待新连接...") conn, addr = sock.accept() # 3. 等待客户端连接,阻塞函数 # print(f"conn:{conn},addr:{addr}") logger.info(f"来自于客户端{addr}的请求成功") #===== 创建一个客户端的线程对象 ===== t = threading.Thread(target=conn_hendler, args=(conn,)) t.start()python# 客户端 import socket # (1) 构建客户端套接字对象 sock = socket.socket(family=socket.AF_INET, type=socket.SOCK_STREAM) # (2) 连接服务器 sock.connect(("127.0.0.1", 8899)) while 1: name = input("请输入转换的姓名(英文):") # (3) 发消息: 网络传输的数据一定是字节串 sock.send(name.encode()) # encode() 转换为字节串 # # 客户端退出 if name == "quit": break # (4) 接受来自于服务的响应消息 res = sock.recv(1024) print("来自于服务的响应消息:", res.decode()) # decode() 转换为字符串多线程并发爬虫pythonimport threading import requests import re import time def get_one_img(path, n): domain = "https://pic.netbian.com/" url = domain + path res = requests.get(url) with open(f"./imgs/{n}.jpg", mode="wb") as f: f.write(res.content) print(f"{n}下载成功") start = time.time() n = 1 t_list = [] for page in range(2, 11): res = requests.get(f"https://pic.netbian.com/4kmeinv/index_{page}.html") # print(res.text) ret = re.findall('<img src="(/uploads/allimg/.*?)"', res.text) print(ret) for path in ret: t = threading.Thread(target=get_one_img, args=(path, n)) t.start() t_list.append(t) n += 1 for t in t_list: t.join() print("耗时:", time.time() - start)
3)线程池
系统启动一个新线程的成本是比较高的,因为它涉及与操作系统的交互。
在这种情形下,使用线程池可以很好地提升性能,尤其是当程序中需要创建大量生存期很短暂的线程时,更应该考虑使用线程池。
线程池在系统启动时即创建大量空闲的线程,程序只要将一个函数提交给线程池,线程池就会启动一个空闲的线程来执行它。
当该函数执行结束后,该线程并不会死亡,而是再次返回到线程池中变成空闲状态,等待执行下一个函数。
此外,使用线程池可以有效地控制系统中并发线程的数量。
当系统中包含有大量的并发线程时,会导致系统性能急剧下降,甚至导致解释器崩溃,而线程池的最大线程数参数可以控制系统中并发线程的数量不超过此数。
程序需要时,从线程池中抽取空闲线程使用,使用完毕后再放回线程池
import time
from concurrent.futures import ThreadPoolExecutor

def task(i):
    print(f'任务{i}开始!')
    time.sleep(i)
    print(f'任务{i}结束!')
    return i

start = time.time()
pool = ThreadPoolExecutor(3) # 创建线程池
future_list = []
for i in range(1,10):
    pool.submit(task, i)
    future = pool.submit(task, i)
    # print(f"future{i}的结果", future.result()) # 将会导致串行
    future_list.append(future)
pool.shutdown()  # 阻塞等待所有任务线程
print(f"程序耗时{time.time() - start}秒钟")
print("future_list: ", future_list)
print([future.result() for future in future_list])
使用线程池来执行线程任务的步骤如下:
- 调用
ThreadPoolExecutor类的构造器创建一个线程池。- 定义一个普通函数作为线程任务。
- 调用
ThreadPoolExecutor对象的submit()方法来提交线程任务。- 当不想提交任何任务时,调用
ThreadPoolExecutor对象的shutdown()方法来关闭线程池。
4)互斥锁
并发编程中需要解决一些常见的问题,例如资源竞争和数据同步。
由于多个线程或进程可以同时访问共享的资源,因此可能会导致数据不一致或错误的结果。
为了避免这种情况,需要采用合适的同步机制,如互斥锁、信号量或条件变量,来确保对共享资源的访问是同步和有序的。
import time
import threading

num = 0  # 设定一个共享变量
Lock = threading.Lock() # 创建锁
def addNum():
    global num  # 在每个线程中都获取这个全局变量
	# 在需要同步进行的地方加锁
    Lock.acquire() # 上锁
    temp = num + 1
    time.sleep(0.0001) # 模拟耗时(CPU 可能被切换)
    # 没有上锁,程序还未修改num 的值就走了
    num = temp
    Lock.release() # 放锁

thread_list = []
for i in range(100):
    t = threading.Thread(target=addNum) # 创建线程
    t.start()
    thread_list.append(t)

for t in thread_list:  # 等待所有线程执行完毕
    t.join()
print('Result: ', num)
5)线程队列
(1)队列的基本语法
线程队列是一种线程安全的数据结构,用于在线程之间传递和共享数据。
它提供了一种解耦的方式,使生产者线程能够将数据放入队列,而消费者线程可以从队列中获取数据进行处理,从而实现线程之间的通信和协调。
线程队列的主要目的是解决多线程环境下的数据共享和同步问题。
在多线程编程中,如果多个线程同时访问共享资源,可能会导致数据的不一致性和竞争条件。
通过使用线程队列,可以避免直接访问共享资源,而是通过队列来传递数据,从而保证线程安全。
import queue
# 创建具有固定大小的队列
# q = queue.Queue() # 默认为 0
q = queue.Queue(3)
# FIFO:先进先出
q.put(100)  # 将元素item放入队列
q.put(200)
q.put(300)
# q.put(400) # 队列已满,会阻塞
# 获取队列中的元素
print(q.get())
print(q.get())
print(q.qsize()) # 返回队列中的元素个数
print(q.empty()) # 如果队列为空,返回True;否则返回False
print(q.get())
# print(q.get()) # 队列已空,会阻塞
线程队列还提供了一些特性和机制,如阻塞和超时等待。当队列为空时,消费者线程可以选择阻塞等待新的数据被放入队列,并且可以设置超时时间。
这样可以避免消费者线程空转浪费资源,只有在有新的数据可用时才会继续执行。
(2)生产者-消费者模型
常见的线程队列模型是生产者-消费者模型。
生产者线程负责生成数据并将其放入队列,而消费者线程则从队列中获取数据并进行处理。
通过使用队列作为缓冲区,生产者和消费者之间解耦,可以实现高效的线程间通信。
# 案例1
import queue
import time
import threading

q = queue.Queue() # 创建一个空的队列

def producer():
    for i in range(1, 11):
        time.sleep(1) # 实现生产一个消费一个的效果
        q.put(i) # 将数据放入队列
        print(f"生产者生产数据 {i}")
    print("生产者结束")

def consumer():
    while 1:
        val = q.get() # 从队列中取出数据
        print("消费者消费数据:", val)

        if val == 10:
            print("消费者结束")
            break

p = threading.Thread(target=producer)
p.start()
time.sleep(1)
c = threading.Thread(target=consumer)
c.start()# 案例1
import queue
import time
import threading
q = queue.Queue() # 创建一个空的队列
def producer():
for i in range(1, 11):
time.sleep(1) # 实现生产一个消费一个的效果
q.put(i) # 将数据放入队列
print(f"生产者生产数据 {i}")
print("生产者结束")
def consumer(name):
while 1:
val = q.get() # 从队列中取出数据
time.sleep(3) # 消费能力弱
print(f"消费者{name}消费数据:", val)
if val == 10:
print("消费者结束")
break
p = threading.Thread(target=producer)
p.start()
time.sleep(1)
c1 = threading.Thread(target=consumer, args=("消费线程1",))
c1.start()
c2 = threading.Thread(target=consumer, args=("消费线程2",))
c2.start()总而言之,线程队列是一种重要的多线程编程工具,用于实现线程安全的数据传递和同步。它提供了一种简单而高效的方式,让多个线程能够安全地共享和处理数据,从而提高程序的并发性和可靠性。
多进程实现
由于GIL的存在(进程中),Python中的多线程其实并不是真正的多线程,如果想要充分地使用多核CPU的资源,在python中大部分情况需要使用多进程。
multiprocessing包是Python中的多进程管理包。
- 与
threading.Thread类似,它可以利用multiprocessing.Process对象来创建一个进程。该进程可以运行在Python程序内部编写的函数。 Process对象与Thread对象的用法相同,也有start(),run(),join()的方法。multiprocessing包中也有Lock/Event/Semaphore/Condition类 (这些对象可以像多线程那样,通过参数传递给各个进程),用以同步进程,其用法与threading包中的同名类一致。- 所以,
multiprocessing的很大一部份与threading使用同一套API,只不过换到了多进程的情境。
python的进程调用:
import multiprocessing
import time

def foo():
    print("foo start...")
    time.sleep(5)
    print("foo end...")

def bar():
    print("bar start...")
    time.sleep(3)
    print("bar end...")

if __name__ == '__main__':
    start = time.time()
    # 创建进程
    t1 = multiprocessing.Process(target=foo, args=())
    t1.start()
    t2 = multiprocessing.Process(target=bar, args=())
    t2.start()
    # 等待所有子线程结束
    t1.join()  # 等待子线程t1
    t2.join()  # 等待子线程t2
    print("Completion time:", time.time() - start)
IO 密集型:文件操作,数据库操作,网络请求(web 请求 或者 爬虫应用)
计算密集型任务:纯计算
计算密集型任务:
import threading
import time

def foo(x):
    ret = 1
    for i in range(x):
        ret += i
    print(ret)

start = time.time()
# ===== 串行版本 ======
# foo(120000000)
# foo(120000000)
# foo(120000000)
# ===== 多线程版本 =====
t1 = threading.Thread(target=foo, args=(120000000,))
t1.start()
t2 = threading.Thread(target=foo, args=(120000000,))
t2.start()
t3 = threading.Thread(target=foo, args=(120000000,))
t3.start()
t1.join()
t2.join()
t3.join()
end = time.time()
print(end - start) # 18.78641414642334import multiprocessing
import time
def foo(x):
ret = 1
for i in range(x):
ret += i
print(ret)
start = time.time()
# ===== 多进程版本 =====
if __name__ == '__main__':
p1 = multiprocessing.Process(target=foo, args=(120000000,))
p1.start()
p2 = multiprocessing.Process(target=foo, args=(120000000,))
p2.start()
p3 = multiprocessing.Process(target=foo, args=(120000000,))
p3.start()
p1.join()
p2.join()
p3.join()
end = time.time()
print(end - start) # 9.807664394378662这个程序展示了三种不同的执行方式:串行版本、多线程版本和多进程版本,并统计了它们的执行时间。
串行版本:
- 在串行版本中,
foo(120000000)被连续调用了三次,以便计算累加和。 - 这种方式是单线程执行的,每个调用都会阻塞其他调用的执行,直到计算完成并打印结果。
- 执行时间是三次调用的总和。
- 在串行版本中,
多线程版本:
- 在多线程版本中,使用了三个线程并发执行三次调用:
t1 = threading.Thread(target=foo, args=(120000000,))。 - 每个线程独立执行一次计算,并打印结果。
- 由于全局解释器锁(GIL)的存在,多线程并不能真正实现并行计算,因此在CPU密集型任务上可能无法获得明显的性能提升。
- 执行时间是最长的单个线程的执行时间。
- 在多线程版本中,使用了三个线程并发执行三次调用:
多进程版本:
- 在多进程版本中,使用了三个进程并发执行三次调用:
p1 = multiprocessing.Process(target=foo, args=(120000000,))。 - 每个进程独立执行一次计算,并打印结果。
- 多进程可以实现真正的并行计算,每个进程都在独立的Python解释器中运行,不受GIL的限制。
- 执行时间是最长的单个进程的执行时间。
- 在多进程版本中,使用了三个进程并发执行三次调用:
协程并发
协程,又称微线程,纤程。英文名Coroutine。一句话说明什么是线程:协程是一种用户态的轻量级线程。
协程拥有自己的寄存器上下文和栈。协程调度切换时,将寄存器上下文和栈保存到其他地方,在切回来的时候,恢复先前保存的寄存器上下文和栈。
因此:协程能保留上一次调用时的状态(即所有局部状态的一个特定组合),每次过程重入时,就相当于进入上一次调用的状态
换种说法:进入上一次离开时所处逻辑流的位置。
1)Greenlet 库
greenlet是对Python标准库中的yield关键字进行封装的库。它允许我们在协程中使用yield语句来暂停和恢复执行,从而实现协程的功能。
在greenlet中,协程被称为greenlet对象。我们可以创建一个greenlet对象,并使用它的switch方法来切换协程的执行。
当一个协程暂停时,它的状态会被保存下来,可以在需要时恢复执行。
from greenlet import greenlet

def foo():
    print("foo step1")  # 第2步:输出 foo step1
    gr_bar.switch()     # 第3步:切换到 bar 函数
    print("foo step2")  # 第6步:输出 foo step2
    gr_bar.switch()     # 第7步:切换到 bar 函数,从上一次执行的位置 继续向后执行

def bar():
    print("bar step1")  # 第4步:输出 bar step1
    gr_foo.switch()     # 第5步:切换到 foo 函数,从上一次执行的位置 继续向后执行
    print("bar step2")  # 第8步:输出 bar step2

if __name__ == '__main__':
    # 创建协程对象
    gr_foo = greenlet(foo)
    gr_bar = greenlet(bar)
    gr_foo.switch()     # 第1步:去执行 foo 函数

# 注意:switch中也可以传递参数用于在切换执行时相互传递值。
Python greenlet库提供了一种轻量级的协程实现方式,适合处理高并发和I/O密集型任务。其简单易用的API和良好的兼容性使其成为Python开发者的理想选择。
2)asyncio模块
asyncio即Asynchronous I/O是python一个用来处理并发(concurrent)事件的包,是很多Python异步架构的基础,多用于处理高并发网络请求方面的问题。
为了简化并更好地标识异步IO,从Python 3.5开始引入了新的语法async和await,可以让coroutine的代码更简洁易读。
asyncio 被用作多个提供高性能 Python 异步框架的基础,包括网络和网站服务,数据库连接库,分布式任务队列等等。
asyncio 往往是构建 IO 密集型和高层级 结构化 网络代码的最佳选择。
(1)基本使用
import asyncio
import time

async def task(i):  # 协程函数
    print(f"task {i} start")
    await asyncio.sleep(1) # 模拟IO事件
    print(f"task {i} end")

# 1)构建事件循环对象
# loop = asyncio.get_event_loop()
# 2)构建协程(coroutine)对象,将协程对象加入时间循环中
# tasks = [task(1), task(2)]
# 3)收集任务并等待
# loop.run_until_complete(asyncio.wait(tasks))
# run_until_complete阻塞调用,直到协程全部运行结束才返回
# asyncio.wait:将协程任务进行收集,功能类似后面的asyncio.gather
# loop.close()

# === 新写法(3.12) ===
async def main():
    await asyncio.gather(task(1), task(2))

start = time.time()
asyncio.run(main())
print("cost timer:", time.time() - start)
(2)任务对象
task: 任务,对协程对象的进一步封装,包含任务的各个状态
asyncio.Task是Future的一个子类,用于实现协作式多任务的库
且Task对象不能用户手动实例化,通过下面2个函数 loop.create_task() 或 asyncio.ensure_future() 创建。
import asyncio, time
def task01_callback(obj):
    print("obj:", obj)
    print("hello task01 finished")
    print(obj.done(), obj.result())
async def work(i, n):  # 使用async关键字定义异步函数
    print('任务{}等待: {}秒'.format(i, n))
    await asyncio.sleep(n)  # 休眠一段时间
    print('任务{}在{}秒后返回结束运行'.format(i, n))
    return i + n

start_time = time.time()  # 开始时间
# 创建任务
tasks = [asyncio.ensure_future(work(1, 1)),
         asyncio.ensure_future(work(2, 2)),
         asyncio.ensure_future(work(3, 3))]

tasks[1].add_done_callback(task01_callback) # 给任务2对象绑定一个回调函数

loop = asyncio.get_event_loop() # 创建事件循环
loop.run_until_complete(asyncio.wait(tasks)) # 收集任务并等待所有任务完成
loop.close()

print('运行时间: ', time.time() - start_time)
for task in tasks:
    print('任务执行结果: ', task.result())
(3)新版本语法支持
async.create_task()创建task
async.gather()获取返回值
async.run()运行协程python# 用gather()收集返回值 import asyncio, time def task01_callback(obj): print("obj:", obj) print("hello task01 finished") print(obj.done(), obj.result()) async def work(i, n): # 使用async关键字定义异步函数 print('任务{}等待: {}秒'.format(i, n)) await asyncio.sleep(n) # 休眠一段时间 print('任务{}在{}秒后结束'.format(i, n)) return i + n async def main(): tasks = [asyncio.create_task(work(1, 1)), asyncio.create_task(work(2, 2)), asyncio.create_task(work(3, 3))] tasks[1].add_done_callback(task01_callback) # 给任务2 对象绑定一个回调函数 # 将task作为参数传入gather,等异步任务都结束后返回结果列表 # response = await asyncio.gather(tasks[0], tasks[1], tasks[2]) response = await asyncio.gather(*tasks) print("异步任务结果:", response) start_time = time.time() # 开始时间 asyncio.run(main()) print('运行时间: ', time.time() - start_time)
3)基于协程的异步爬虫应用
(1)同步请求爬虫
import os.path
import time
import requests
import re

def get_page_img_urls(page):
    # 获取页面内容
    res = requests.get(f"https://pic.netbian.com/4kmeinv/index_{page}.html")
    # 使用正则表达式提取图片URL
    ret = re.findall('<img src="(/uploads/allimg/.*?)"', res.text)
    print(ret)
    return ret

def download_one_img(url, n):
    # 下载单张图片
    res = requests.get(url)
    f = open(f"./imgs/{n}", "wb")
    f.write(res.content)
    f.close()
    print(f"{n}下载成功")

def download_page_imgs(img_urls):
    domain = "https://pic.netbian.com/"
    for path in img_urls:
        title = os.path.basename(path)
        url = domain + path
        download_one_img(url, title)

def main():
    start = time.time()
    for i in range(2, 6):
        page_img_urls = get_page_img_urls(i)
        # 获取页面中的图片URL列表
        download_page_imgs(page_img_urls)
    # 下载页面中的所有图片
    end = time.time()
    print("cost timer:", end - start)

main()
(2)基于asyncio库的异步爬虫
import time
import requests
import re
import asyncio
import aiohttp
import os

async def get_page_img_urls(page):
    # 获取页面内容
    # res = requests.get(f"https://pic.netbian.com/4kmeinv/index_{2}.html")

    async with aiohttp.ClientSession() as session:
        async with session.get(f"https://pic.netbian.com/4kmeinv/index_{page}.html", verify_ssl=False) as res:
            data = await res.content.read()
            # 使用正则表达式提取图片URL
            ret = re.findall('<img src="(/uploads/allimg/.*?)"', data.decode("GBK"))
            print(ret)
            return ret

async def download_one_img(url, n):
    # 下载单张图片
    async with aiohttp.ClientSession() as session:
        async with session.get(url, verify_ssl=False) as res:
            f = open(f"./imgs/{n}", "wb")
            data = await res.content.read()
            f.write(data)
            f.close()
            print(f"{n}下载成功")

async def download_page_imgs(img_urls):
    domain = "https://pic.netbian.com/"

    for path in img_urls:
        title = os.path.basename(path)
        url = domain + path
        await download_one_img(url, title)

async def main():
    start = time.time()
    for i in range(2, 6):
        # 获取页面中的图片URL列表
        page_img_urls = await get_page_img_urls(i)
        # 下载页面中的所有图片
        await download_page_imgs(page_img_urls)
    end = time.time()
    print("cost timer:", end - start)

asyncio.run(main())在这段代码中,async with 是用于创建一个异步上下文管理器,而不是用于等待异步操作的完成。异步上下文管理器可以在异步代码块中管理资源的获取和释放。
在这个例子中,aiohttp.ClientSession() 返回一个异步上下文管理器对象 session,它负责管理与服务器的连接和会话。使用 async with 可以确保在代码块执行完毕后,自动关闭和释放与服务器的连接。
在 async with session.get(...) 中,session.get(...) 返回一个异步上下文管理器对象 response,它负责发送 HTTP 请求并获取响应。在 async with 代码块内部,我们可以使用 response 对象进行响应的处理,例如读取响应的内容。
今日作业
1)多线程日志记录
需求:你需要设计一个多线程日志记录系统,用于记录系统的运行日志。
系统有三个日志级别:INFO、WARNING 和 ERROR。每个级别的日志都应该以不同的时间间隔写入日志文件。具体要求如下:
- 创建三个线程对象,分别表示 INFO、WARNING 和 ERROR级别的日志线程。
- 每个线程对象应该无限循环,在循环中以指定的时间间隔向日志文件写入相应级别的日志消息。
- INFO 级别的日志线程每秒写入一条日志消息。
- WARNING 级别的日志线程每三秒写入一条日志消息。
- ERROR 级别的日志线程每五秒写入一条日志消息。
- 日志消息的格式为:时间戳 - [级别]: 消息内容。
pythonimport threading import time def log_worker(file, level, intercal): """ file: 日志文件路径; level: 日志级别; intercal: 日志间隔时间 """ while 1: time_stamp = time.time() msg = f"Log Message with level {level}" # 日志消息内容 log_entry = f"{time_stamp} - [{level}:{msg}]" # 日志条目 with open(file, "a") as f: f.write(log_entry) time.sleep(intercal) def main(): path = "logs.log" # 创建线程对象 info_thread = threading.Thread(target=log_worker, args=(path, "INFO", 1)) warning_thread = threading.Thread(target=log_worker, args=(path, "WARNING", 3)) error_thread = threading.Thread(target=log_worker, args=(path, "ERROR", 5)) # 启动线程 info_thread.start() warning_thread.start() error_thread.start() # 阻塞 info_thread.join() warning_thread.join() error_thread.join() if __name__ == '__main__': main()
2)订单处理系统
实现一个订单处理系统,其中包括生产者和消费者线程。
生产者线程负责生成订单消息,并将其放入订单消息队列中。生成的订单消息应包括以下信息:
- 订单号(唯一标识订单)
- 顾客姓名
- 订单总金额
消费者线程负责从订单消息队列中获取订单消息,并进行处理。处理订单消息的具体操作是发送短信通知给顾客,通知顾客订单已支付成功,请耐心等待配送。发送短信通知时,应包括以下内容:
- 顾客姓名
- 订单号
生产者线程和消费者线程应该并发执行,以实现订单的实时处理。
订单消息的生成和发送短信通知的操作应具有随机性,以模拟实际应用中的不同订单和通知情况。例如,可以使用随机数生成订单号和随机选择顾客姓名和订单金额。
程序应该持续运行,直到手动终止。生产者线程应不断生成订单消息并放入队列,而消费者线程应不断从队列中获取消息并处理。
python# 1. 实现一个订单处理系统,其中包括生产者和消费者线程。 # 2. 生产者线程负责生成订单消息,并将其放入订单消息队列中。生成的订单消息应包括以下信息: # - 订单号(唯一标识订单) # - 顾客姓名 # - 订单总金额 # 3. 消费者线程负责从订单消息队列中获取订单消息,并进行处理。处理订单消息的具体操作是发送短信通知给顾客,通知顾客订单已支付成功,请耐心等待配送。发送短信通知时,应包括以下内容: # - 顾客姓名 # - 订单号 # 4. 生产者线程和消费者线程应该并发执行,以实现订单的实时处理。 # 5. 订单消息的生成和发送短信通知的操作应具有随机性,以模拟实际应用中的不同订单和通知情况。例如,可以使用随机数生成订单号和随机选择顾客姓名和订单金额。 # 6. 程序应该持续运行,直到手动终止。生产者线程应不断生成订单消息并放入队列,而消费者线程应不断从队列中获取消息并处理。 import queue import threading import time import random def generate_order(): # 生成订单消息的函数 order_id = str(int(time.time())) # 在实际应用中可根据需求生成订单号 customer_name = random.choice(["John Doe", "Mike", "Tom"]) total_amount = random.choice([100, 99, 123, 78, 56, 199]) # 生成订单总金额 order = { 'order_id': order_id, 'customer_name': customer_name, 'total_amount': total_amount } return order def producer(): while 1: inter = random.randint(1, 5) # 时间间隔 print(f"{inter}秒后下一个订单就来了!") time.sleep(inter) order = generate_order() # 生成订单 order_queue.put(order) # 将订单放入队列 print(f"订单 {order['order_id']} 已生成") def consumer(): while 1: # 从队列中获取订单 order = order_queue.get() # 处理订单消息(发送短信通知) # 在实际应用中可根据需求发送短信通知 print(f"向顾客 {order['customer_name']} 发送短信通知:您的订单 {order['order_id']} 已支付成功,请耐心等待配送。") print(f"订单 {order['order_id']} 已处理") print("=" * 80) order_queue = queue.Queue() p = threading.Thread(target=producer) p.start() c = threading.Thread(target=consumer) c.start()
3)异步操作数据库
将下面的案例数据库操作改为使用异步IO并发执行
import time

def execute_query(query):
    # 模拟数据库查询,这里可以替换为实际的数据库查询操作
    # 这里使用 time.sleep 来模拟查询的阻塞操作
    import time
    time.sleep(1)
    return f"Result for query: {query}"

def main():
    queries = [
        "SELECT * FROM table1",
        "SELECT * FROM table2",
        "SELECT * FROM table3"
    ]
    results = []
    for query in queries:
        result = execute_query(query)
        results.append(result)
    print(results)

if __name__ == '__main__':
    start = time.time()
    main()
    end = time.time()
print("cost timer:", end - start)import asyncio
import time
async def execute_query(query):
# 模拟数据库查询,这里可以替换为实际的数据库查询操作
# 这里使用 await asyncio.sleep 来模拟查询的阻塞操作
import time
await asyncio.sleep(1)
return f"Result for query: {query}"
async def main():
queries = [
"SELECT * FROM table1",
"SELECT * FROM table2",
"SELECT * FROM table3"
]
tasks = []
for query in queries:
task = asyncio.create_task(execute_query(query))
tasks.append(task)
results = await asyncio.gather(*tasks) # 收集任务结果
print(results)
if __name__ == '__main__':
start = time.time()
asyncio.run(main())
end = time.time()
print("cost timer:", end - start)相关链接
- Python 多进程与多线程 — 进程/线程并发
- Python 迭代器与生成器进阶 — 生成器基础